 Simone
分词器(Tokenizer)详解
的有关信息介绍如下:分词器(Tokenizer)详解
一、概念
Tokenizer分词器是一种工具,它将一段文本分割成很多单词或者子单词,这些单词或子单词通过token词表被映射成一串id。简而言之,Tokenizer的作用是将字符序列转化为数字序列,以便作为模型的输入。由于神经网络模型无法直接处理文本数据,因此我们需要先用分词器将文本转换为数字形式,这个过程被称为编码(Encoding)。编码包含两个步骤:
二、三种分词粒度
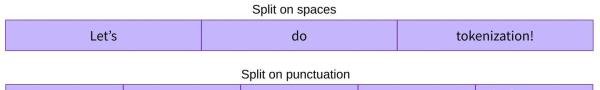
Tokenizer主要有三种分词粒度:word(词)、char(字符)、subword(子词)。
2.1 word
词表大,稀有词学习效果不佳;
存在OOV(可能超出词表外的词)问题;
无法处理单词形态关系和词缀关系,如"cat"和"cats"会被赋予不同的编号,无法表示出这种关联性。
2.2 character
无法承载丰富的语义,英文中尤为明显(但中文较为合理,中文中用此种方式较多);
序列长度大幅增长。

2.3 subword
2.3.1 Byte-Pair Encoding (BPE)
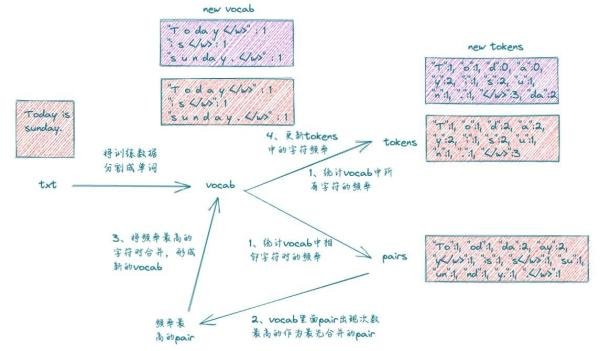
将训练数据分割成单词,可以是简单的空格分词(如GPT-2、RoBERTa),也可以是更先进的基于规则的分词(如XLM、FlauBERT)。
生成单词集合vocab,并确定训练数据中每个单词出现的频次。
根据单词集合vocab产生基础词典,包含集合中所有的符号。
学习融合的规则,即寻找出现频率最高的字符对,并将新的字符对合并到vocab中。
循环上述步骤,直到词典的大小满足期望的词典大小要求。
2.3.2 Byte-level BPE (BBPE)
初始化词汇表:开始时,BBPE将每个字符都视为一个词汇(但这里是以字节为单位)。
字节对频率统计:对输入文本进行扫描,统计所有相邻字节对的出现频率。
合并频率最高的字节对:找到出现频率最高的字节对,并将它们合并成一个新的字节对,添加到词汇表中。
重复步骤2和3,直到达到指定的词汇表大小或迭代次数。
编码文本:将输入文本中的字节对替换为词汇表中对应的新词汇。
2.3.3 WordPiece
2.3.4 Unigram
2.3.5 SentencePiece
三、典型大模型分词器类型
| 分词方法 | 典型模型 || --- | --- || BPE | GPT, GPT-2, GPT-J, GPT-Neo, RoBERTa, BART, LLaMA, ChatGLM-6B, Baichuan || WordPiece | BERT, DistilBERT, MobileBERT || Unigram | AlBERT, T5, mBART, XLNet |
Tokenizer作为自然语言处理中的重要工具,其选择和使用对于模型的性能和效果具有重要影响。在实际应用中,需要根据具体任务和模型特点选择合适的分词器类型和参数设置。